求职记忆引擎测评
DrawOffer 求职记忆引擎测评:能力判断准确率 97.7%,预测下一题 AUC 0.843,96.3% 的结论能追溯到原话;在三个公开教育数据集上与 BKT、PFA 相当。附完整数据与测评说明。
我们用四组测试检验 DrawOffer 的求职记忆引擎:和“把全部记录交给大模型”、开源记忆框架 Mem0 正面对比;放到三个公开的学生作答数据集上,和学界常用的知识追踪模型比较;检查结论能否复现、能否追溯到原话、删除资料后是否删得干净;再把虚构求职者剧本扩到 102 份,按方向、级别和问题类型分层看结果。这里是完整报告的网页版,包括引擎领先的地方,也包括它落后的地方。
- 能力判断准确率:97.7%(大模型读全部记录 81.4%,Mem0 81.4%)
- 预测下一题 AUC:0.843(大模型 0.781,Mem0 0.736)
- 结论能追溯到原话:96.3%(Mem0 的回答只有 1.6%)
- 删除资料后残留的结论:0(逐一删除 85 份来源)
1. 测评要回答什么
DrawOffer 引擎读取一位求职者的简历、目标岗位、模拟面试和真实面试记录,判断他在每个知识点上的水平,指出简历说法是否写高、经历是否讲得清楚,并预测下一道题能否答好。对这样一个系统,我们最关心四个问题:
- 和通用做法相比,它判断得准不准?通用做法指把记录直接交给大模型,或者使用开源记忆框架 Mem0。
- 放到教育领域公开的学生作答数据上,它和学界常用的知识追踪模型 BKT、IRT、PFA、DKT 比怎样?
- 它自身是否可靠:结论能不能复现、能不能追溯到原话、删除资料后是否删得干净,推断有多快?
- 在更大、更多样的剧本集上,它在哪些方向、哪些问题类型上表现好,在哪些地方表现差?
| 结论 | 关键数据 | 出处 |
|---|---|---|
| 判断知识点水平比直接用大模型准 | 准确率 97.7%(42/43);大模型读全部记录 81.4%,Mem0 + 大模型 81.4% | 第 3 节 |
| 预测下一题能否答好,优于通用记忆 | AUC 0.843;大模型 0.781,Mem0 0.736;log loss 比两者低 34%–36% | 第 3 节 |
| 结论有据可查 | 96.3% 的结论能追溯到原话;Mem0 的回答只有 1.6% | 第 3 节 |
| 推断可复现 | 同样的输入重复推断,25/25 份剧本逐字节相同 | 第 5 节 |
| 删除资料删得干净 | 逐一删除 85 份来源,残留结论 0 条 | 第 5 节 |
| 原话不是编的 | 结论引用的 420 条原话全部能在原文中找到 | 第 5 节 |
| 在公开教育数据上达到经典模型水平 | AUC 与 BKT、PFA 相差在 ±0.005 以内;隔天后的作答高出 0.02–0.03 | 第 4 节 |
| 推断快、不花模型费用 | 3000 次作答全量推断 0.28 秒,新增一场 0.04 秒 | 第 7 节 |
2. 测评怎么设计
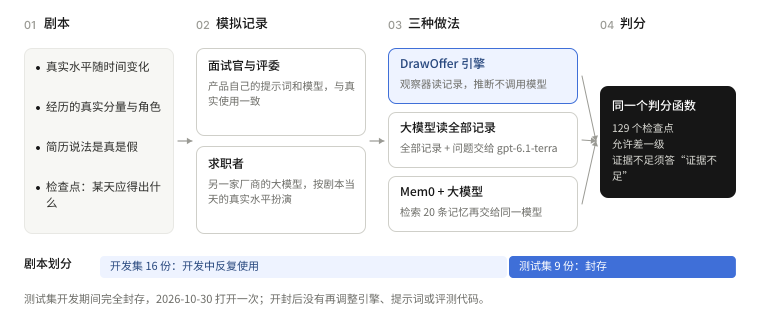
求职场景没有现成的公开数据集:真实简历和面试记录涉及个人信息,也没有人知道一位求职者在某个知识点上的“真实水平”。所以我们采用“剧本”的方法:先写下一位虚构求职者的完整设定,再按产品的真实流程生成他的记录,最后检查系统给出的结论是否符合剧本。
剧本
每份剧本写明这位求职者各个知识点在不同时间的真实水平、每段经历的真实分量和角色,以及简历上每条说法是真是假。剧本还规定了一组检查点:在某个日期,系统应当给出什么样的结论,比如“这一天 Redis 应在‘掌握’一档,允许差一级”“这一天不应报出任何 MySQL 的缺口”“这段经历的角色写高了”。
模拟记录
记录按产品的真实流程生成:面试官出题和追问、评委评分,都使用产品自己的提示词;求职者由另一家厂商的大模型按剧本当天的真实水平扮演。这样,记录里会自然出现真实使用中会有的噪声,比如评分偏差、答非所问、临场发挥失常。
开发集与测试集
第一组对比使用 25 份剧本、129 个检查点,其中 16 份为开发集,9 份为测试集。测试集在开发期间完全封存,2026-10-30 打开一次;开封后没有再调整引擎、提示词或评测代码。扩充实验的 102 份剧本按编号的哈希划分,测试集 37 份在 2026-11-01 打开一次。
- 能力判断准确率
- 能力等级类检查点的通过率。允许与剧本相差一级;剧本规定证据不足时,必须回答“证据不足”。
- 预测下一题 AUC 与 log loss
- 每道知识题吸收之前,预测“能通过这一层”的概率,标签是产品评分器的判定。AUC 越高越好,log loss 越低越好;AUC 区间按题重抽样 2000 次得到。
- 原话可追溯
- 结论附带的原话按省略号分段后,每一段都能在原始记录里逐字找到才算。
- 一致性
- 同一输入独立重跑 5 次,每次都重新调用模型;看结论相同、答案逐字相同的比例。
3. 与通用记忆方案正面对比
我们选了两种最常见的做法作为对照。第一种不做任何记忆处理,把截至检查日的全部记录按时间排好,连同问题一起交给一个更强的大模型;第二种使用开源记忆框架 Mem0,逐条写入记录,回答每个问题时检索 20 条记忆再交给同一个大模型。
| 做法 | 怎么工作 | 模型 |
|---|---|---|
| DrawOffer 引擎 | 观察器把每条记录读成结构化观察并逐字摘录原话;推断不调用模型,事先不知道会被问什么 | 观察器 deepseek-v4.1-flash |
| 大模型读全部记录 | 到检查日为止的全部记录按时间排好,连同问题一起交给模型,要求结构化作答并摘录原话 | gpt-6.1-terra(推理强度 medium) |
| Mem0 + 大模型 | mem0ai 2.2.1 逐条写入记录、删除来源时同步删除;每题检索 20 条记忆,只看检索结果 | 同上;本机嵌入 bge-small-zh-v1.5 |
全部 25 份剧本的结果
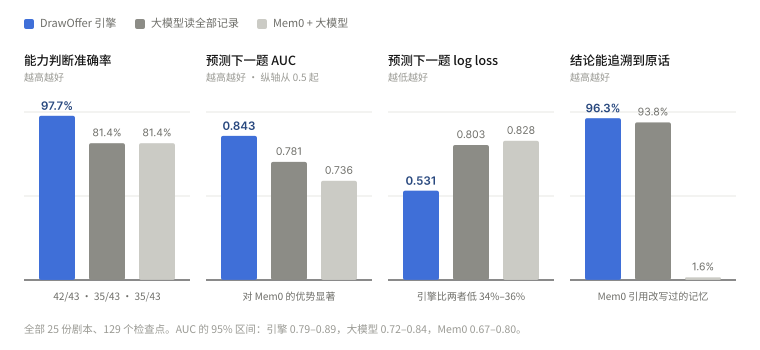
| 指标 | DrawOffer 引擎 | 大模型读全部记录 | Mem0 + 大模型 |
|---|---|---|---|
| 能力判断准确率(允许差一级) | 97.7%(42/43) | 81.4%(35/43) | 81.4%(35/43) |
| 预测下一题 AUC | 0.843(0.79–0.89) | 0.781(0.72–0.84) | 0.736(0.67–0.80) |
| 预测下一题 log loss | 0.531 | 0.803 | 0.828 |
| 结论能追溯到原话 | 96.3%(520/540) | 93.8%(120/128) | 1.6%(2/128) |
| 全部检查点通过率 | 81.4%(105/129) | 84.5%(109/129) | 83.0%(107/129) |
| 同一输入 5 次,结论都相同 | 86.8%(112/129) | 86.8%(112/129) | 83.7%(108/129) |
| 同一输入 5 次,答案逐字相同 | 76.0%(98/129) | 70.5%(91/129) | 67.4%(87/129) |
引擎在能力判断和预测上明显领先:能力等级判断 42/43,另外两种做法都是 35/43;预测下一题的 AUC 为 0.843,log loss 为 0.531,比大模型和 Mem0 低 34%–36%,说明引擎给出的概率不仅排序更准,数值本身也更接近真实结果。
统计上,我们按题重抽样(共 94 道题)计算 AUC 差的 95% 区间。引擎减 Mem0 为 +0.035 到 +0.178,不含 0,优势显著;引擎减“大模型读全部记录”为 −0.005 到 +0.129,下限略低于 0,所以还不能说一定更好。
封存的测试集
| 指标 | DrawOffer 引擎 | 大模型读全部记录 | Mem0 + 大模型 |
|---|---|---|---|
| 能力判断准确率 | 100.0%(15/15) | 93.3%(14/15) | 86.7%(13/15) |
| 预测下一题 AUC | 0.809(0.72–0.89) | 0.768(0.67–0.87) | 0.743(0.65–0.84) |
| 预测下一题 log loss | 0.529 | 0.831 | 0.840 |
| 结论能追溯到原话 | 96.7%(177/183) | 88.9%(40/45) | 0.0%(0/45) |
| 全部检查点通过率 | 88.9%(40/45) | 88.9%(40/45) | 84.4%(38/45) |
| 同一输入 5 次,结论都相同 | 88.9%(40/45) | 93.3%(42/45) | 86.7%(39/45) |
测试集上的方向和全部数据一致:能力判断 15/15 全对,高于另外两种做法。测试集只有 45 个检查点,AUC 差的区间都跨过了 0(引擎减大模型 −0.070 到 +0.146,引擎减 Mem0 −0.043 到 +0.174),这一部分只能作为方向上的佐证。
按检查点类型看:引擎落后在哪里
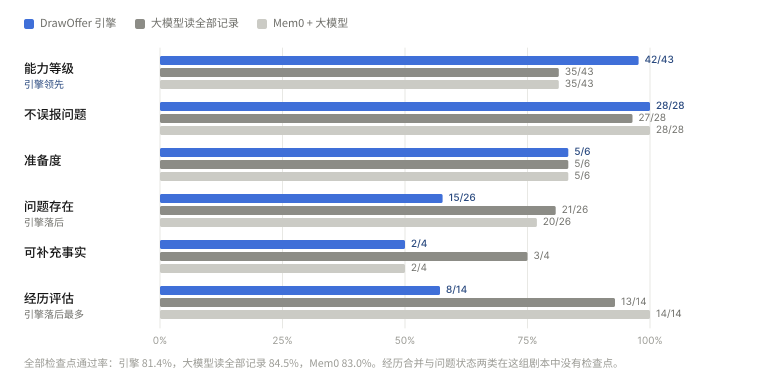
全部检查点通过率,引擎为 81.4%,略低于“大模型读全部记录”的 84.5%。拆开看,引擎领先的是能力等级;落后最多的是经历评估(8/14,大模型 13/14,Mem0 14/14)和问题存在(15/26,大模型 21/26)。经历评估要判断一段经历在追问中讲得是否清楚,这恰恰是大模型直接阅读全文最擅长的,也是我们后面重点改进的方向。在“不该报的问题不要报”这一类检查点上,三种做法都接近满分(引擎 28/28)。
原话可追溯
引擎对人的判断,96.3%(520/540)能追溯到原始记录里的原话;大模型为 93.8%,Mem0 只有 1.6%。原因在于 Mem0 回答时引用的是它自己抽取、改写过的记忆,而不是原文:这些引用有 93.0% 能在它看到的记忆里找到,但不在原始记录里。对求职场景来说,这一点很重要:当系统说“你在某场面试中没讲清楚”,求职者应当能看到自己当时到底说了什么。
引擎另有派生结论(准备度、被问过的题、岗位要求)230 条,其中 153 条带有来源。准备度和“被问过的题”在产品数据里还没有挂接依据,这是待补的缺口,不计入上面的 96.3%。
这个对比偏向对照组
- 对照组被直接问到考点。对照组被问“X 现在什么水平”“是否存在 Y 问题”,引擎事先不知道会被问什么,要自己发现所有问题。
- 对照组的模型更强。gpt-6.1-terra 强于引擎观察器使用的 deepseek-v4.1-flash。
- 对照组没有误报的机会。对照组只回答被问的检查点;引擎如果多报了别的问题,会在“不误报问题”检查点上扣分。
所以对照组的分数偏高,引擎的优势是保守估计。
成本
两种对照做法跑完全部对比,共调用 gpt-6.1-terra 1696 次(另有 396 次命中缓存),消耗约 4060 万 token,失败 0 次。引擎的推断环节不调用模型,只有观察器读取记录时调用一个较小的模型,而且同样的输入只读一次。
4. 公开知识追踪数据集
知识追踪是教育领域的标准问题:根据学生过去的作答,预测下一题能否答对。它和我们的问题不完全相同,学生作答只有对错,面试作答有层级和追问;但两者的核心都是“从一串作答里估计会不会”。所以我们把引擎放到三个公开数据集上,和学界常用的四个模型比较,检验它的推断部分是否站得住。
| 数据集 | 学生 | 作答 | 知识点 | 时间戳 |
|---|---|---|---|---|
| ASSISTments 2009 | 4,027 | 282,969 | 123 | 无 |
| EdNet-KT1 | 5,000 | 703,306 | 188 | 有 |
| Junyi Academy | 5,000 | 787,452 | 664 | 有 |
EdNet 和 Junyi 学生太多,从至少有 20 次作答的学生中抽取 5000 名,每人取最早的 500 次作答。三个数据集都按学生做 5 折交叉验证:每个模型只在训练折上拟合;对测试折里每位学生的每次作答,只用他之前的作答来预测。
- DrawOffer 引擎
- 产品做法:只从训练集估计每个知识点的难度;每次作答带真实时间,预测取引擎吸收这次作答之前给出的通过概率。遗忘与稳定度使用产品参数,没有在这些数据上调整。
- BKT
- 贝叶斯知识追踪,pyBKT 1.4.3,每个知识点一个隐马尔可夫模型。
- PFA
- 按成功、失败次数做逻辑回归。
- IRT
- Rasch 模型,从训练集学生身上估计每道题的难度。
- DKT
- 基于 LSTM 的深度知识追踪。
- 对照组
- 引擎关闭遗忘;引擎加上每道题的难度(产品里没有这一步)。
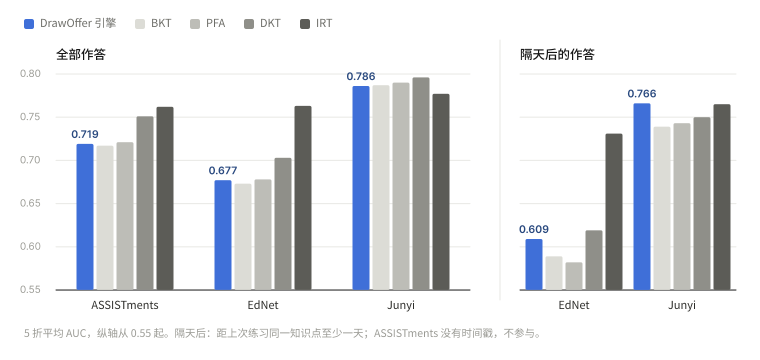
| 模型 | ASSISTments | EdNet | EdNet 隔天后 | Junyi | Junyi 隔天后 |
|---|---|---|---|---|---|
| DrawOffer 引擎 | 0.719 | 0.677 | 0.609 | 0.786 | 0.766 |
| BKT | 0.717 | 0.673 | 0.589 | 0.787 | 0.739 |
| PFA | 0.721 | 0.678 | 0.582 | 0.790 | 0.743 |
| DKT(深度模型) | 0.751 | 0.703 | 0.619 | 0.796 | 0.750 |
| IRT | 0.762 | 0.763 | 0.731 | 0.777 | 0.765 |
怎么读这组结果
整体与经典模型 BKT、PFA 持平。三个数据集上,引擎与 BKT、PFA 的 AUC 差都在 ±0.005 以内。这些模型是专门为这类数据设计、并在每个数据集上单独训练的;引擎是为求职场景设计的通用推断,没有针对这些数据调参。
隔了一段时间再练的题,引擎更准。只看距上次练习同一知识点至少一天的作答,EdNet 上引擎比 BKT 高 0.021、比 PFA 高 0.028;Junyi 上比 BKT 高 0.027、比 PFA 高 0.023、比深度模型 DKT 高 0.016,与 IRT 持平。这正是遗忘建模起作用的地方。
遗忘模型确实起作用。同一个引擎打开遗忘与关闭遗忘相比,隔天后的 AUC 在 EdNet 上平均高 0.0062,在 Junyi 上高 0.0030,两个数据集的 10 折全部为正。
和 IRT、DKT 的差距来自题目难度。IRT 和 DKT 会从大量其他学生身上学习“每道题有多难”,引擎在产品里不这样做。作为对照,给引擎补上每道题的难度之后,ASSISTments 上为 0.768(IRT 0.762),EdNet 上为 0.758(IRT 0.763),Junyi 上为 0.790(IRT 0.777)。在求职场景里,面试题很少完全重复,而且我们不希望用别人的作答去校准你的结论,所以产品没有采用这一步。
各数据集的完整结果
| 模型 | AUC | RMSE | log loss |
|---|---|---|---|
| 引擎 + 题目难度(对照) | 0.7676 ± 0.0034 | 0.4244 | 0.5372 |
| IRT | 0.7623 ± 0.0030 | 0.4250 | 0.5381 |
| DKT | 0.7514 ± 0.0055 | 0.4271 | 0.5443 |
| PFA | 0.7213 ± 0.0067 | 0.4382 | 0.5672 |
| DrawOffer 引擎 | 0.7189 ± 0.0084 | 0.4392 | 0.5692 |
| BKT | 0.7173 ± 0.0060 | 0.4390 | 0.5707 |
| 引擎(默认参数,不用训练集) | 0.7010 ± 0.0090 | 0.4503 | 0.5919 |
| 知识点平均通过率 | 0.6223 ± 0.0051 | 0.4637 | 0.6197 |
| 模型 | AUC | RMSE | log loss | 隔天后 AUC |
|---|---|---|---|---|
| IRT | 0.7626 ± 0.0009 | 0.4345 | 0.5583 | 0.7313 |
| 引擎 + 题目难度(对照) | 0.7577 ± 0.0012 | 0.4368 | 0.5627 | 0.7250 |
| DKT | 0.7033 ± 0.0022 | 0.4530 | 0.5979 | 0.6185 |
| PFA | 0.6783 ± 0.0029 | 0.4601 | 0.6124 | 0.5815 |
| DrawOffer 引擎 | 0.6765 ± 0.0028 | 0.4624 | 0.6169 | 0.6093 |
| BKT | 0.6730 ± 0.0030 | 0.4623 | 0.6173 | 0.5886 |
| 引擎(关闭遗忘,对照) | 0.6725 ± 0.0030 | 0.4639 | 0.6200 | 0.6031 |
| 引擎(默认参数,不用训练集) | 0.6521 ± 0.0026 | 0.4719 | 0.6363 | 0.5921 |
| 知识点平均通过率 | 0.6407 ± 0.0028 | 0.4717 | 0.6362 | 0.5624 |
| 模型 | AUC | RMSE | log loss | 隔天后 AUC |
|---|---|---|---|---|
| DKT | 0.7960 ± 0.0057 | 0.3317 | 0.3613 | 0.7499 |
| 引擎 + 题目难度(对照) | 0.7903 ± 0.0071 | 0.3332 | 0.3653 | 0.7677 |
| PFA | 0.7903 ± 0.0069 | 0.3324 | 0.3632 | 0.7432 |
| BKT | 0.7868 ± 0.0074 | 0.3335 | 0.3708 | 0.7390 |
| DrawOffer 引擎 | 0.7863 ± 0.0070 | 0.3340 | 0.3664 | 0.7659 |
| 引擎(关闭遗忘,对照) | 0.7851 ± 0.0073 | 0.3348 | 0.3679 | 0.7629 |
| IRT | 0.7768 ± 0.0067 | 0.3375 | 0.3722 | 0.7648 |
| 引擎(默认参数,不用训练集) | 0.7397 ± 0.0094 | 0.3630 | 0.4283 | 0.7028 |
| 知识点平均通过率 | 0.7318 ± 0.0086 | 0.3512 | 0.3981 | 0.7210 |
几点说明:ASSISTments 没有时间戳,作答按顺序每题间隔 1 分钟,遗忘模型在这里不起作用;pyBKT 1.4.3 与 NumPy 2 不兼容,运行时把一个数组转成标量,它的 E 步改用编译版提速,两者预测逐位相同,有单元测试检查,复跑结果也逐位相同。
5. 稳定性与可追溯性
这一组测试把观察器的输出固定下来(读取缓存),单独检验推断本身,覆盖全部 25 份剧本。
| 测试 | 结果 |
|---|---|
| 同一输入在同一进程内推断 5 次 | 25/25 份剧本、60 个时点的结论逐字节相同 |
| 换 2 个新进程、不同哈希种子再推断 | 25/25 份剧本逐字节相同 |
| 逐一删除每份来源(85 次) | 只依赖被删来源的 176 条结论全部消失;残留结论 0 条,仍引用被删来源的结论 0 条,残留观察 0 条 |
| 结论引用的原话 | 420/420 条能在原文中找到(按省略号分段核对;整句直接匹配 348 条) |
这意味着三件事。可审计:同一份资料永远得出同一个判断,任何一条结论都可以在事后完整重算、逐步检查。删得干净:用户删除一份资料后,由它得出的结论随之消失,满足个人信息删除的要求。有据可查:每个判断都能指回求职者说过的原话。
6. 扩充到 102 份剧本
25 份剧本足以做正面对比,但不足以看清引擎在不同人群、不同问题上的表现。我们把剧本扩充到 102 份、581 个检查点,覆盖 5 个方向(后端、前端、AI、产品、运营)和 4 个级别(实习、校招、中级、资深),每个组合 5–6 份。
新增剧本按问题类型分配重点:简历写高或写低(技能熟练度、经历角色)、岗位知识缺口、经历先讲不清后讲清、简历与面试数字矛盾、多份简历的经历合并、复习到期与休眠、通用能力证据不足,以及表现一致、不该报任何问题的对照组。新增 77 份剧本的求职者由 claude-haiku-5.5 按剧本当天的真实水平扮演,原有 25 份复用此前记录;面试官与评委仍使用产品自己的提示词和 deepseek-v4.1-flash。
模拟本身也有误差:知识题的评分深度与剧本设定完全一致的比例,开发集为 50%,差一级以内为 97%;测试集分别为 56% 和 94%。划分按剧本编号的哈希:开发集 65 份、370 个检查点;测试集 37 份、210 个检查点,2026-11-01 打开一次,开封后没有再调整引擎或剧本。
- 测试集检查点通过:80.5%(169/210;开发集 302/370)
- 测试集问题召回率:0.64(上一代引擎只有 0.27)
- 测试集能力档位合理:91%(开发集 97%)
- 测试集预测下一题 AUC:0.715(上一代引擎 0.688)
| 指标 | 开发集 v3 | 开发集 v2 | 测试集 v3 | 测试集 v2 | 测试集 v3 的 95% 区间 |
|---|---|---|---|---|---|
| 能力档位合理 | 0.967 | 0.978 | 0.913 | 0.957 | 0.80–0.97 |
| 问题准确率 | 0.902 | 0.909 | 0.875 | 0.818 | 0.69–0.96 |
| 问题召回率 | 0.578 | 0.312 | 0.636 | 0.273 | 0.47–0.78 |
| 证据门槛(不误报) | 0.969 | 0.985 | 0.962 | 0.975 | 0.89–0.99 |
| 问题状态变化 | 0.273 | 0.000 | 0.125 | 0.000 | 0.02–0.47 |
| 经历去重 | 1.000 | 0.875 | 1.000 | 1.000 | 0.70–1.00 |
| 经历评估 | 0.552 | 0.569 | 0.581 | 0.613 | 0.41–0.74 |
测试集上,当前引擎的问题召回率是上一代的两倍多(0.636 对 0.273),问题准确率也更高(0.875 对 0.818);能力档位与上一代接近。测试集与开发集的总通过率接近,但单次划分还不足以完全排除过拟合。模型标签已缓存时,单人状态推断的 P95 为 0.054 秒,不含模型调用耗时。
按方向与级别
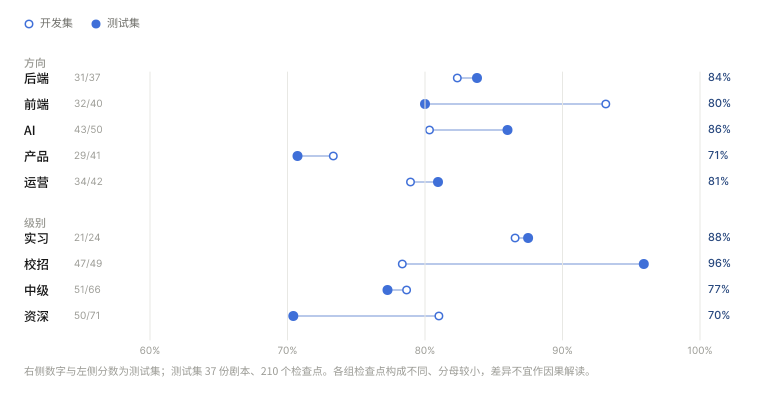
| 分组 | 开发集 | 测试集 |
|---|---|---|
| 后端 | 70/85(82%) | 31/37(84%) |
| 前端 | 68/73(93%) | 32/40(80%) |
| AI | 49/61(80%) | 43/50(86%) |
| 产品 | 55/75(73%) | 29/41(71%) |
| 运营 | 60/76(79%) | 34/42(81%) |
| 实习 | 103/119(87%) | 21/24(88%) |
| 校招 | 76/97(78%) | 47/49(96%) |
| 中级 | 59/75(79%) | 51/66(77%) |
| 资深 | 64/79(81%) | 50/71(70%) |
产品方向最低。产品与运营的剧本主要考经历叙述,正好落在下面说的短板上;资深级别也是同样的原因。各组的检查点构成不同、样本较小,这些差异不宜作因果解读。
按检查点类型
| 检查点类型 | 开发集 | 测试集 |
|---|---|---|
| 能力档位 | 89/92(97%) | 42/46(91%) |
| 经历评估 | 32/58(55%) | 18/31(58%) |
| 经历合并 | 8/8(100%) | 9/9(100%) |
| 简历写高 | 13/20(65%) | 4/5(80%) |
| 简历写低 | 10/11(91%) | 8/9(89%) |
| 岗位知识缺口 | 7/13(54%) | 4/5(80%) |
| 数字矛盾 | 3/7(43%) | 3/5(60%) |
| 经历讲不清 | 1/9(11%) | 1/6(17%) |
| 讲不清后讲清 | 0/6(0%) | 0/5(0%) |
| 缺口解除或休眠 | 2/4(50%) | 1/3(33%) |
| 复习到期 | 2/3(67%) | 1/3(33%) |
| 岗位准备度 | 4/4(100%) | 2/2(100%) |
| 可补充事实 | 2/2(100%) | 0/2(0%) |
依赖经历评估模型的检查点,测试集通过 52/77(68%);其余检查点 117/133(88%)。所有“不该报”的干扰项通过率都在 92% 以上,误报少。
找到并修复的问题:经历评估模型
扩充后,我们定位到经历评估模型(读一道经历题的回答,判断本人分量、角色和每次追问讲没讲清)的两个问题。一是分量常给“未知”,还会把角色词填进分量字段:修复前单票给出分量的只有 51%。把分量和角色都改成固定的可选值之后,单票给出分量 58%、给出角色 48%。二是复述追问的草稿限 40 字,超长的整条作废,我们放宽到了 80 字。
| 版本 | 通过 | 问题准确率 | 问题召回率 | 经历评估 | 单票给出分量 | 单票给出角色 |
|---|---|---|---|---|---|---|
| 修复前 | 292/370 | 0.860 | 0.578 | 0.414 | 51% | 49% |
| 只把分量改成可选值 | 300/370 | 0.800 | 0.500 | 0.672 | 75% | 27% |
| 分量和角色都改成可选值(采用) | 302/370 | 0.902 | 0.578 | 0.552 | 58% | 48% |
这是一次采样对比,不能单凭该结果确认变化的因果;表中前两版的单票比例来自开发集,采用版来自开发集与测试集合计,不能直接作同样本比较。“经历讲不清”仍然几乎报不出,原因有二:真实面试复盘入库时每题只有一组问答,追问被并进了回答,判断讲清程度的模型只看追问,所以真实面试里的讲不清引擎看不到;另外,部分剧本只把目标方面设成“部分讲清”,按设计本就不报。前者需要改复盘的入库方式,尚未实施。
同一剧本模拟 3 次
开发集 65 份剧本各模拟 3 次(复用首轮,追加两轮求职者回答及面试判定;相同请求复用缓存)。370 个检查点中,322 个每次结果都相同(87%);三次各自的通过数为 302、297、307,按多数次通过计为 306/370。一致率同时包含三轮都通过和三轮都失败的检查点,不等于正确率,它衡量的是剧本模拟和模型判定整条链路的波动。补跑只补齐服务限流造成的缺失,没有按分数挑选结果。
7. 性能
我们用引擎自带的生成模型造出模拟学习者,每场 6 题、每两天一场,历史从 10 场到 500 场;每档 5 位学习者,每人计时 3 次。测试机器是 Apple M3 笔记本(8 核)。
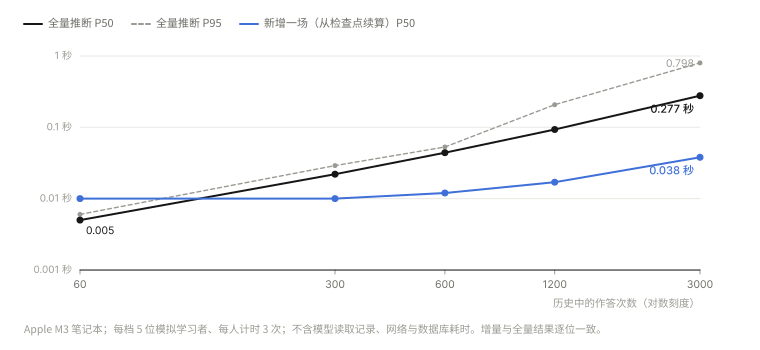
| 历史长度 | 观察条数 | 全量推断 P50 / P95 | 增量更新一场 P50 | 增量与全量一致 |
|---|---|---|---|---|
| 60 次作答(10 场) | 120 | 0.005 / 0.006 秒 | 0.010 秒 | 5/5 |
| 300 次作答(50 场) | 600 | 0.022 / 0.029 秒 | 0.010 秒 | 5/5 |
| 600 次作答(100 场) | 1200 | 0.044 / 0.053 秒 | 0.012 秒 | 5/5 |
| 1200 次作答(200 场) | 2400 | 0.093 / 0.207 秒 | 0.017 秒 | 5/5 |
| 3000 次作答(500 场) | 6000 | 0.277 / 0.798 秒 | 0.038 秒 | 5/5 |
3000 次作答的长历史,全量推断 0.28 秒;新增一场面试,从检查点续算只要 0.038 秒,结果与全量重算逐位一致。这些是纯计算的测量,不含模型读取记录、网络和数据库的耗时。
8. 限制与引用注意事项
为了让这些数字经得起检验,下面几点请在引用时一并说明,不要写过头。
- 剧本是虚构的,而且由开发方起草。25 份与 102 份剧本都还没有经过两位独立标注人核对;模拟面试的作答由大模型按剧本扮演,偶尔会编出剧本里没有的数字。这不是真实用户数据,真实数据校准尚未开始。
- 正面对比的样本量小。129 个检查点,测试集只有 45 个,所以每个数都附了区间。引擎与“大模型读全部记录”的 AUC 差,95% 区间为 −0.005 到 0.129,跨过了 0,统计上还不能说一定更好;对 Mem0 的优势在统计上显著(0.035 到 0.178)。扩充到 102 份剧本后,正面对比还没有在扩充后的剧本上重跑。
- 不是所有指标都领先。全部检查点通过率,引擎 81.4%,低于大模型读全部记录的 84.5%;主要短板在经历评估(8/14 对 13/14)。
- “5 次结论一致”不是 100%。端到端一致率是 86.8%,和大模型持平;推断这一步本身是 100% 可复现的。
- 预测标签来自产品评分器,不是人工判定。评分器本身的误差另有测评;AUC 只取第 1 次运行。
- 公开数据集上不是第一。整体 AUC 低于 IRT 和 DKT,差距来自引擎不从其他用户身上学题目难度。可以说“与经典模型相当”,不要说“超过最先进模型”。
- Mem0 的配置。Mem0 的实体链接依赖 spaCy 英文模型,对中文不起作用,所以没有启用;对比中的 Mem0 是一个特定版本与配置下的结果,不代表 Mem0 的全部能力。
- “不花模型费用”只针对推断环节。观察器读取记录时仍要调用模型。
9. 后续与复现
接下来有三项工作。第一,在 102 份剧本上重跑正面对比:大模型与 Mem0 两个对照目前只跑了 25 份。第二,用真实数据校准:产品已经实现面试前的预测存档、面试后的勾选与校准报表,开启后即可积累“系统预测会问什么、实际问了什么、答得怎样”的数据。第三,补短板:真实面试复盘的讲清程度判断、数字矛盾识别,以及给准备度和“被问过的题”挂上依据。
全部方法、测评代码与原始结果 JSON 见 github.com/ql-link/DrawOffer-Eval,重跑命令见该仓库的说明。核心引擎代码不公开,生成的对话和模型缓存不随仓库分发,因此部分实验无法完全独立复现。更严格的实验设计、机制消融与讨论,见研究论文;系统各层的设计,见架构设计。