DrawOffer: Evidence-Grounded Longitudinal User-State Modeling for Career Support
DrawOffer 论文:把语言模型的观察抽取与可追溯记录上的确定性推断分开,在证据不足时暂不判断。102 份虚构人物、580 个计分检查点与三个公开知识追踪数据集上的评估。
Lele Xu†* · Yuning Bian† · Yifan Yuan†
Anhui University of Technology(安徽工业大学) · † 共同第一作者 · * 通讯作者
Abstract
Career-support assistants must distinguish user claims from evidence of current ability and withhold judgments when evidence is insufficient. DrawOffer separates language-model observation extraction from deterministic inference over source-linked records to maintain uncertain ability estimates, experience assessments, and revisable issues. We evaluate 102 fictional personas with 580 scored checkpoints, a historical full-context and Mem0 comparison, and three auxiliary knowledge-tracing datasets. On 37 test personas, DrawOffer passes 169/210 checkpoints; checkpoint-defined issue precision and recall are 0.875 and 0.636. Across three development simulations, 87.0% of checkpoint verdicts agree, including persistent failures. A cache-only development ablation replacing answer-evidence requirements with confidence-only settlement reduces majority-vote passes from 306 to 293 of 370 and issue precision from 0.927 to 0.725. Equalizing positive source weights improves predictive metrics without changing total passes; removing decay gives mixed results. These findings support an exploratory systems contribution centered on evidence sufficiency. Developer-authored scenarios, unmatched baseline models, historical test exposure, and incomplete public artifacts limit generalization and independent reproduction.
中文摘要
求职支持助手必须区分用户的自我陈述与当前能力的证据,并在证据不足时暂不作出判断。DrawOffer 把语言模型的观察抽取与基于可追溯记录的确定性推断分开,维护带不确定度的能力估计、经历评估与可修订的问题。我们在 102 份虚构人物、580 个计分检查点上评估系统,并给出一组与全文上下文、Mem0 的历史对比,以及三个辅助的知识追踪数据集实验。在 37 份测试人物上,DrawOffer 通过 169/210 个检查点;按检查点定义的问题精确率与召回率为 0.875 与 0.636。三次开发集模拟中,87.0% 的检查点判定一致(其中包括始终失败的检查点)。一项只读缓存的开发集消融把“作答证据要求”替换为“只看置信度”的定论方式,多数票通过数从 306/370 降到 293/370,问题精确率从 0.927 降到 0.725。把所有正的来源权重设为相等,预测指标有所改善而总通过数不变;去掉衰减的结果则方向不一。这些发现支持一项以“证据充分性”为中心的探索性系统贡献。开发者编写的场景、未对齐的对照模型、历史测试暴露以及尚不完整的公开材料,限制了结论的推广与独立复现。
1. 研究问题与贡献
求职助手会积累各种来源的记录:简历陈述、岗位要求、模拟面试作答、用户自述的面试复盘和准备活动。这些记录在“认识论”上的角色不同。简历陈述是一种主张;一次作答是在特定条件下对表现的观察;岗位描述规定的是目标,而不是求职者能力的证据。把三者当作可以互换的、可检索的事实,可能把一个没有依据的主张变成能力估计,也可能把“缺少证据”变成一个负面判断。
论文研究的问题是:助手怎样从这些记录中维护可修订的用户状态估计,同时在证据不足时暂不下结论。DrawOffer 把结构化观察的抽取与确定性的状态推断分开,输出包括能力档位、经历评估、主张与证据之间的差异、相对目标的知识缺口,以及问题的出现与解决。这些是对用户历史的派生判断,而不是逐字的回忆。
论文的贡献有三项:
- 一个与来源相连的求职状态系统,带有明确的“暂不判断”条件;
- 一项受控评估,同时报告预期行为与失败;
- 一组配对的开发集消融,把证据充分性与来源权重、衰减分开检验。
与历史记忆方案的对比和教育预测实验提供背景,各有不同的效度限制。论文定位为应用系统研究,其中的概率组件使用的是成熟方法。论文依次回答四个问题:系统能否产生预期的求职状态;历史配置之间如何比较;教育序列在预测与衰减上揭示了什么;模拟的随机性和机制的移除如何影响结果。
3. 任务与系统
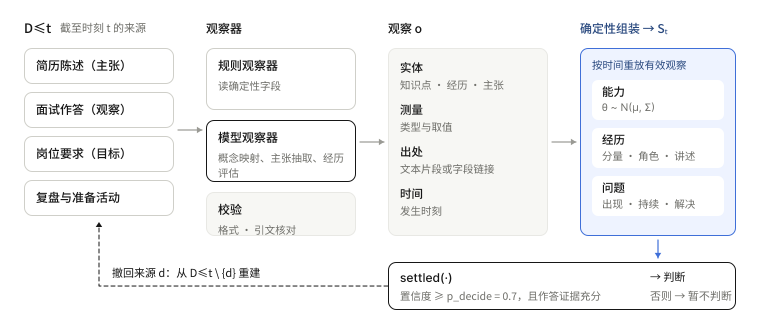
来源、观察与输出
记 D≤t 为时刻 t 之前可用的来源,每个来源有编号、发生时间和类型。观察器把记录映射为观察,观察包含目标实体、测量类型、取值与出处;出处可以是一段精确的文本,也可以是指向结构化字段的链接。确定性组装按时间顺序重放有效观察,构造状态 Sₜ。
系统区分三件事:用户陈述了什么,一次观察到的行为支持什么,当前模型推断出什么。外部的岗位要求可以定义目标差距,但不能单独抬高能力估计。直接证据不足时,输出可以保持“未评估”,所以“估计偏低”和“评估不足”是两种不同的状态。
能力输出涉及知识点与通用能力;经历输出包括贡献分量、角色、深度,以及特定的追问方面是否讲清;问题包括相对目标的差距、写高或写低的主张,以及讲不清的经历。问题状态跟踪出现、持续与解决,而不是把每次抽取都当作永久事实。
观察的抽取与校验
规则观察器读取确定性字段;模型观察器完成语义任务,比如把题目映射到目录概念、抽取主张、评估经历回答。结构化输出要经过格式校验,带引文的字段要与原文核对。引文能匹配,只说明这段文本存在,并不说明由此得出的判断在语义上成立。
经历回答观察器对每道题请求三票,每票最多尝试两次,汇总成功的票;即使只有一票成功,也可以决定结果,因此投票结果必须同时报告失败次数。论文所用的版本把贡献分量限定为 W1–W5 或未知,把角色限定为参与、负责、主导、独立或未知,不合法的取值记为未知;追问复述允许 80 个字符。
能力更新
论文核查的推断路径用高斯状态 θ ~ N(μ, Σ) 表示能力。一条观察作用在投影 z = uᵀθ 上,其先验均值与方差为 m = uᵀμ、v = uᵀΣu。对二值作答 y、区分度 a 和难度(或深度门槛)b:
p(y = 1 | z) = σ( a (z − b) )
p(z | y) ∝ N(z; m, v) · [ p(y | z) ]^r
σ 为逻辑函数;u 把一条观察映射到能力坐标;r ≥ 0 用来调节观察的影响,并不表示“正确”的校准概率。
一维拉普拉斯近似给出众数 ẑ 与方差 v̂。记 c = Σu,秩一更新为:
μ⁺ = μ + (c / v)(ẑ − m)
Σ⁺ = Σ + (c cᵀ / v²)(v̂ − v)
ℓ′(z) = −(z − m)/v + r a (y − p)
ℓ″(z) = −1/v − r a² p (1 − p),p = σ(a(z − b))
默认的来源权重为:真实面试观察 1.0,模拟面试 0.8,自述 0.3;外部材料和单纯的用户操作,对能力证据的权重为 0。这些是专家设定的假设,而不是经验上的最优值。
时间演化让估计回到基线均值 μ₀、参考协方差 Σ₀。对间隔 Δ 和稳定度 sᵢ,令 fᵢ = exp(−Δ/sᵢ)、gᵢ = √(1 − fᵢ²),F = diag(f),G = diag(g):
μ′ = μ₀ + F (μ − μ₀)
Σ′ = F Σ F + G Σ₀ G
直接作答会更新稳定度。这个机制削弱的是旧证据对当前状态的说明力,并不是一个经过验证的个体遗忘规律。缓存重放使用推断引擎 1 和参数集 2026.10.0;正文中的“v3”“v2”是求职系统的业务版本,不是推断引擎的编号。后来的因子化、场次效应和有序误差扩展不在场景结论的范围内。
证据充分性与可修订的问题
仅有一个置信的后验并不总是足以作出判断。定论决策(settled)把后验置信度与 p_decide = 0.7 比较,同时考虑直接作答的证据:视目标而定,包括作答次数、覆盖的不同知识点、新鲜度和最短的时间跨度。其他输出有各自的评估与覆盖条件。这些门槛的目的,是防止一句陈述或一次狭窄的观察被泛化为宽泛的不足。
经历讲述的各个方面使用各自加权的“清楚 / 部分 / 不清楚”证据、时间衰减,以及出现与解除的阈值,所以不存在一个移除后就能关闭所有证据规则的单一门槛;消融实验会精确说明改动的是哪一个决策函数。当一个来源被删除或失效时,状态可以从剩余来源重建,被撤回的来源不再支撑任何结论。这一点针对的是推断上的依赖,并不意味着从模型服务商的日志、缓存或所有存储副本中删除。
4. 评估设计
受控的求职场景
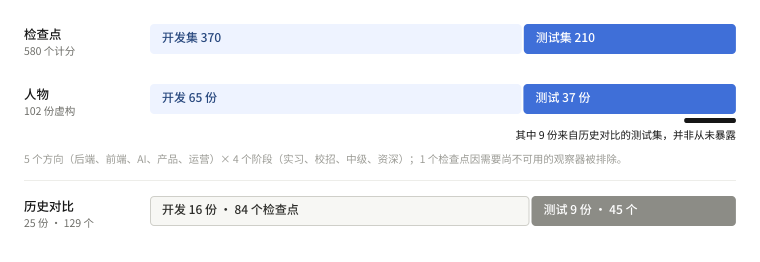
扩充后的场景集包含 102 份虚构人物,覆盖后端、前端、AI、产品和运营五个方向,以及实习、校招、中级、资深四个阶段,共 581 个检查点定义。其中 1 个需要一个尚不可用的材料观察器,被排除,剩下 580 个计分检查点:65 份开发人物 370 个,37 份测试人物 210 个。
检查点规定特定日期上可观察的状态,包括预期的能力档位、必须出现或禁止出现的问题、经历评估、重复经历的合并和状态转移。能力与经历档位的检查一般允许相差一档;明确要求“评估不足”的状态必须精确匹配。“问题不存在”的检查把已解决和沉睡的问题视为不活跃。补充事实的检查使用归一化后的文本包含或数字匹配,这是一种比语义蕴含更弱的启发式。场景与预期由开发团队编写,并不是独立的人工金标。
第一轮保留了原有 25 份人物的记录,并新增 77 份由本地配置的 Kiro CLI 模型标识 claude-haiku-5.5 模拟的人物;面试官与评分调用使用产品提示词,观察器目标为 deepseek-v4.1-flash。另外两次模拟覆盖全部 65 份开发人物。这些是本地调用的标识,而不是经独立核验的不可变服务商快照。相同的观察器请求在多次运行之间可以复用缓存,因此三次运行并不是对每次模型调用的独立重抽样。
37 份测试人物包含历史对比中的 9 份测试人物,因此它不是一个完全从未暴露过的测试集。扩充后的测试集于 2026 年 11 月 1 日开启;之后的机制分析只使用开发数据,没有在扩充测试集的结果上调整引擎。
历史记忆对比
历史对比使用 25 份人物、129 个检查点,其中 16 份开发人物、9 份测试人物(45 个检查点)。DrawOffer、全文上下文对照与 Mem0 配置读取相同的底层记录。DrawOffer 的观察器目标为 deepseek-v4.1-flash,对照组作答使用本地 CLI 标识 gpt-6.1-terra。模型身份与预算没有对齐,所以这是系统配置之间的比较,而不是受控的记忆算法比较。
Mem0 适配器声明 mem0ai==2.2.1,使用本地 BAAI/bge-small-zh-v1.5 向量和 Qdrant 存储,按时间顺序把每一段作为用户消息写入,每个问题最多检索 20 条记忆;调用 Memory.add 时没有显式关闭推理,并记录返回的记忆编号以便删除来源。这并不说明 Mem0 只能追加、不能更新记忆,历史上的内部更新操作和跨来源更新后的归属尚未完全还原。
公开的知识追踪实验
辅助实验使用 ASSISTments 2009–2010、EdNet-KT1 和 Junyi Academy,保留规模分别为 4,027 名学生 / 282,969 次作答、5,000 / 703,306 和 5,000 / 787,452,按学生做 5 折划分(种子 0),预测都在吸收当前结果之前进行。
预处理有几处需要说明。ASSISTments 丢弃缺失技能的行,把同一学生同一订单的多行合并为一次作答;由于加载器不提供真实时间戳,作答按一分钟等间隔排列,因此这个数据集不作为遗忘的证据。EdNet 按答案键判对错、按标签取技能,要求至少 20 次保留的作答并取前 500 次;实现中的候选列表在选择之前被排序,所以 EdNet 子集实际上是文件名顺序的前 5000 个合格文件,而不是均匀随机样本。Junyi 以种子 0 抽取 5000 名合格用户,把练习本身同时作为题目和技能。
对照模型的配置:BKT 使用 pyBKT 的 EM,每个技能拟合 5 次;PFA 变体使用 log(1+n) 的成功与失败计数做逻辑回归;IRT 在训练学生上拟合带 L2 惩罚的 Rasch 难度,并在线更新测试学生的能力;DKT 使用 100 个单元的 LSTM。这些是本地的模型族配置,而不是对公开排行榜的复现。“隔天后”子集要求当前题目的所有技能此前都出现过,且距每个技能上次出现至少一天。
指标与统计范围
总体场景通过率是计分检查点中通过的比例。问题指标定义在明确的正例与反例检查点上:TP 为通过的“问题存在”检查,FP 为失败的“问题不存在”检查,精确率为 TP/(TP+FP),召回率为 TP 除以正例检查数。这些是按检查点定义的指标,不是对系统可能输出的所有问题计算的精确率与召回率。开发集消融先对每个检查点取三次运行的多数票,再按人物有放回重抽样 10,000 次得到配对区间(种子 20261101);区间均为探索性的逐点百分位区间,没有做多重比较校正。
5. 结果
扩充后的求职场景
测试集通过 169/210 个检查点(80.5%),第一轮开发集通过 302/370(81.6%)。表 1 比较了两个业务系统版本在测试集上的表现:问题召回率的提升,伴随着能力档位与经历评估表现的下降。223 个测试作答预测的 AUC 为 .7155、log loss 为 .5917,但这并不说明概率是校准的。总体通过率对每个检查点等权,而不是对人物或断言类型等权。
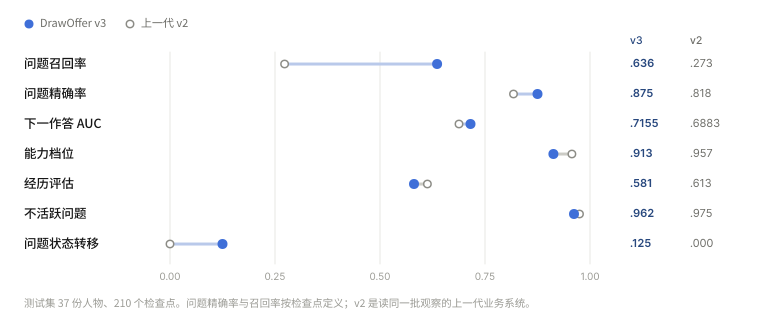
| 指标 | DrawOffer v3 | 上一代 v2 |
|---|---|---|
| 能力档位检查 | .913 | .957 |
| 按检查点定义的问题精确率 | .875 | .818 |
| 按检查点定义的问题召回率 | .636 | .273 |
| 经历评估检查 | .581 | .613 |
| 不活跃问题检查 | .962 | .975 |
| 问题状态转移 | .125 | .000 |
| 经历合并 | 1.000 | 1.000 |
| 准备度检查 | 1.000 | 1.000 |
| 补充事实检查 | .000 | .000 |
| 下一作答 AUC | .7155 | .6883 |
| 下一作答 log loss | .5917 | .6233 |
按方向,测试集通过数为后端 31/37、前端 32/40、AI 43/50、产品 29/41、运营 34/42;按阶段,为实习 21/24、校招 47/49、中级 51/66、资深 50/71。各组的检查点构成不同、分母较小,不能对这些差异作因果解释。
经历讲述的失败相当明显:要求出现“讲不清”问题的检查只有 1/6 通过,随后“已解决”的检查 0/5 通过。检查发现既有实现问题也有基准问题:真实面试复盘把追问文本合并进了一个回答,讲述方面的观察器拿不到预期的追问结构;部分模拟对话从未引出预期的方面。这些结果不应只归因于推断算法。
历史上的通用记忆对比
| 配置 | 全部通过 | 测试通过 | 测试 AUC |
|---|---|---|---|
| DrawOffer | 105/129 | 40/45 | .8093 |
| 全文上下文 | 109/129 | 40/45 | .7677 |
| Mem0 适配器 | 107/129 | 38/45 | .7433 |
DrawOffer 在总体检查点准确率上并不领先。历史测试集的 AUC 点估计更高,但它与全文上下文的差的区间为 [−.0697, .1460],与 Mem0 的差的区间为 [−.0435, .1745],都跨过了 0,且使用的是历史上按题重抽样的方法。
精确来源与引文检查在 540 条原始引擎结论中通过 520 条;把派生状态也算上是 673/770,其中 153/230 涉及派生条目。这些分母不同,不能合并成一个可追溯性的说法。改写过的检索记忆可能不保留逐字的来源片段,所以精确字符串检查对这类配置不利;这些数字衡量的是来源和引文是否存在,而不是真实性或语义支持。
辅助的知识追踪实验
| 配置 | ASSISTments | EdNet | Junyi |
|---|---|---|---|
| 引擎,不训练难度 | .7010 | .6521 | .7397 |
| 引擎,技能难度 | .7189 | .6765 | .7863 |
| 引擎,题目难度 | .7676 | .7577 | .7903 |
| BKT | .7173 | .6730 | .7868 |
| PFA | .7213 | .6783 | .7903 |
| IRT | .7623 | .7626 | .7768 |
| DKT | .7514 | .7033 | .7960 |
难度校准会显著改变引擎的表现,没有哪个配置在所有数据集上胜过所有对照。在 EdNet 的隔天后作答上,技能难度引擎的 AUC 为 .6093,关闭遗忘为 .6031,BKT .5886、PFA .5815、DKT .6185;在 Junyi 上,引擎为 .7659 与 .7629,BKT、PFA、DKT 分别为 .7390、.7432、.7499。衰减带来的 .0062 与 .0030 的提升是描述性的,只适用于这些配置;5 折方向一致并不构成显著性检验,这些结果也不能验证求职状态判断或一般的人类遗忘模型。
稳定性、撤回与计算
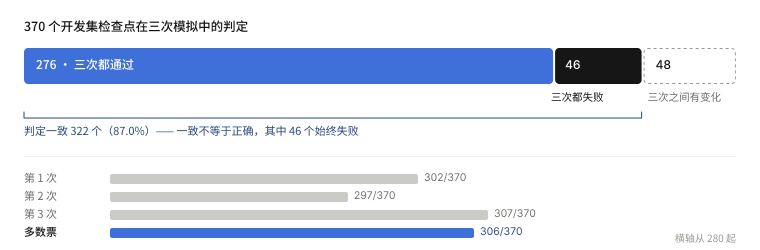
三轮开发集分别通过 302、297 和 307 个检查点(共 370 个),多数票通过 306 个(82.7%)。322 个检查点在三轮中判定一致(87.0%):276 个始终通过,46 个始终失败;48 个有变化。所以一致性也包括持续的错误。这个实验同时包含模拟与观察器的变化,无法单独分离任一部分的随机性。限流造成的缺失输出按原设置补齐;最终的只读缓存重放没有缺失,也没有新的调用。
固定观察后,历史的 25 份人物确定性测试在进程内重复 5 次和两个新进程中给出完全相同的状态。在 85 次来源撤回中,所跟踪的 176 条依赖结论无一留存,也没有残留的来源观察或结论。这些是经过测试的依赖性质,而不是一般意义上的正确性或彻底删除的保证。
合成计时使用每场 6 题、每个规模 5 位学习者、重复 3 次。在 3,000 次作答时,推断引擎 1 的全量重建中位数为 .2767 秒、P95 为 .7985 秒;另一个引擎 2 的全量重建中位数为 1.6033 秒,增量添加一场为 .0384 秒,增量与全量结果在 5 位测试学习者上一致。增量数字不能归到引擎 1 上。这些是不含模型抽取、网络和数据库延迟的纯计算测量,而不是端到端的服务基准。
6. 开发集机制消融
在查看消融输出之前,我们预先记录了干预方式、只用开发集的范围和重抽样方法。所有配置复用同样三组来源记录和结构化观察器缓存。完整配置复现了历史上每一轮失败检查点的集合、汇总指标、多数票失败与预测结果。每次重放都是零模型调用、零缓存缺失、零失败请求,重放过程不构造任何模型网关或数据库客户端。
三种干预在隔离的 Python 进程中进行,不改变产品默认值:
- 相等的正权重:把每一个正的来源类别权重(包括模拟与真实经历的权重)都替换为 1;保留权重为 0 的非证据类别和评分器版本系数。
- 无衰减:把能力与经历的稳定度、讲述方面的半衰期都设为无穷大;保留真实日期、新鲜度规则和最短时间跨度条件。
- 只看置信度的定论:把 Posterior.settled 替换为一个在 p_decide = .7 上检验映射节点后验置信度的判断,去掉作答次数、覆盖知识点和时间跨度的要求;保留其他业务、覆盖与评分规则。
这些是限定范围的干预,并不是移除系统中所有与可靠度、时间或证据相关的操作。
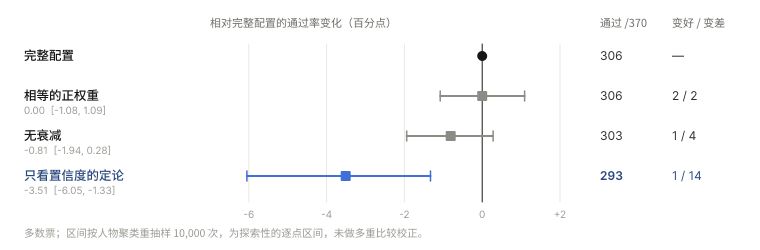
| 配置 | 通过 /370 | 差值 | 探索性 95% 区间 |
|---|---|---|---|
| 完整 | 306 | 0 | — |
| 相等的正权重 | 306 | 0.00 | [−1.08, 1.09] |
| 无衰减 | 303 | −0.81 | [−1.94, 0.28] |
| 只看置信度的定论 | 293 | −3.51 | [−6.05, −1.33] |
只看置信度的定论让 1 个检查点变好、14 个变差;问题精确率从 .9268 降到 .7255,召回率从 .5938 降到 .5781,问题状态的通过率从 .2727 降到 .1818。这个结果在这些受控任务上支持“作答证据要求”,但并不支持置信度门槛本身的校准。需要注意,开发者编写的“问题不存在”检查点明确奖励克制,在声称真实效用之前需要独立的判断。
相等的正权重让 2 个检查点变好、2 个变差;下一作答的 AUC 从 .7867 升到 .7988,log loss 从 .5418 降到 .5208。所以本实验并不支持现有的可靠度权重能带来预测上的改进。无衰减让 1 个检查点变好、4 个变差,AUC 为 .7862、log loss 为 .5389,预测方向不一,通过率的区间也跨过 0。我们把这两个机制作为设计选择保留,但不声称它们都能提升表现。
7. 讨论与局限
得到支持的是什么。最强的局部结果是“只看置信度的定论”带来的退化。它提示我们,应当把“是否允许作出判断”与预测准确率分开评估。这并不证明系统优于其他记忆系统,也不证明来源权重是最优的、能力概率是校准的,或对就业有益。
评估的依赖性。开发者编写的预期可能偏向系统的设计规则,尤其是“问题不存在”检查上的克制。模拟器可能没有引出预期的证据。语义支持与能力真值都没有独立标注。历史测试的暴露、共享的人物与提示词、缓存复用,都限制了独立性;检查点上的精确率也忽略了预定义检查之外的问题。
对照与版本的限制。模型不对齐、服务商记录不完整且不可变性未知,使得历史差异无法归因到记忆算法上。精确引文检查对改写类方法并不中立。25 份与 102 份人物的实验不能合成一个受控的排行榜。缓存重放验证的是当前的重建,而不是整个历史环境或更新的引擎扩展。
迁移与选择的限制。教育作答序列与面试在测量对象和错误产生方式上都不同。EdNet 按文件名顺序的选择可能引入选择偏差;Junyi 把练习当作技能;ASSISTments 在这个加载器里没有真实的时间证据。知识追踪测试是本地预处理下的辅助机制探针,而不是对完整求职支持流程的验证。
已知的系统弱点。经历讲述与解决的检查仍然薄弱,部分原因是缺少追问结构。引文存在比语义蕴含更弱。固定的来源权重和时间设置可能不适合个别用户。系统应当暴露不确定度和证据,而不是把推断出的不足当作经过核实的个人事实呈现。
8. 数据、复现与负责任使用
求职人物全部是虚构的,研究没有使用真实简历或联系方式。教育数据集是现有的公开研究资源,论文不再分发原始数据;公开可得并不意味着可以无限制地再分发,原始的访问与许可条款仍然适用。
测评代码与汇总结果见 github.com/ql-link/DrawOffer-Eval。核心引擎不公开,生成的对话与模型缓存不分发;扩充人物和论文专用补充材料的公开同步尚未核实,因此该仓库无法独立复现全部实验。本地材料保存了消融的汇总、逐人物判定、干预方式与输入哈希;哈希只能证明身份一致,不能证明可得性或语义有效性。
系统用于面向用户的求职准备,而不是自动化的招聘或筛选。真实用户研究需要适当的知情同意、访问控制、撤回程序和相应的伦理审查。这些实验不声称证明了不同人群间的公平性、真实世界的能力或法律合规。
AI 工具的使用。AI 工具协助了实验脚本、分析、文献检索、翻译与起草;模型也按上文所述生成了虚构的互动并抽取观察。AI 生成的修改不构成独立的同行评议,人类作者负责核实并批准所提交的论断、引文与文字。
9. 结论
DrawOffer 把来源记录、结构化观察与带不确定度的用户状态判断分开。受控场景暴露了经历讲述和问题转移行为的不完整;开发集消融在局部支持证据要求,而来源权重与衰减的结果是负面的或方向不一。论文把证据充分性作为长期助手的一个独立评估目标提出,并受上述复现性与外部效度的限制。
参考文献
- A. Maharana, D.-H. Lee, S. Tulyakov, M. Bansal, F. Barbieri, and Y. Fang. Evaluating Very Long-Term Conversational Memory of LLM Agents. In ACL, pp. 13851–13870, 2024.
- D. Wu, H. Wang, W. Yu, Y. Zhang, K.-W. Chang, and D. Yu. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. ICLR, 2025.
- P. Chhikara, D. Khant, S. Aryan, T. Singh, and D. Yadav. Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory. arXiv:2504.19413, 2025.
- P. Rasmussen, P. Paliychuk, T. Beauvais, J. Ryan, and D. Chalef. Zep: A Temporal Knowledge Graph Architecture for Agent Memory. arXiv:2501.13956, 2025.
- W. Xu, Z. Liang, K. Mei, H. Gao, J. Tan, and Y. Zhang. A-MEM: Agentic Memory for LLM Agents. arXiv:2502.12110, 2025.
- J. Liao, Q. Wang, J. Zhu, B. Du, R. Yan, and X. Chen. Belief Memory: Agent Memory Under Partial Observability. arXiv:2605.05583, 2026.
- C. Latimer, N. Boschi, A. Neeser, C. Bartholomew, G. Srivastava, X. Wang, and N. Ramakrishnan. Hindsight: Structured Agent Memory that Retains, Recalls, and Reflects. In ACL System Demonstrations, 2026.
- A. T. Corbett and J. R. Anderson. Knowledge tracing: Modeling the acquisition of procedural knowledge. User Modeling and User-Adapted Interaction, 4:253–278, 1994.
- P. I. Pavlik Jr., H. Cen, and K. R. Koedinger. Performance Factors Analysis — A New Alternative to Knowledge Tracing. In Artificial Intelligence in Education, 2009.
- C. Piech, J. Bassen, J. Huang, S. Ganguli, M. Sahami, L. Guibas, and J. Sohl-Dickstein. Deep Knowledge Tracing. In Advances in Neural Information Processing Systems 28, 2015.
- M. Feng, N. T. Heffernan, and K. R. Koedinger. Addressing the assessment challenge in an intelligent tutoring system that tutors as it assesses. User Modeling and User-Adapted Interaction, 19:243–266, 2009.
- Y. Choi, Y. Lee, D. Shin, J. Cho, S. Park, S. Lee, J. Baek, C. Bae, B. Kim, and J. Heo. EdNet: A Large-Scale Hierarchical Dataset in Education. arXiv:1912.03072, 2019.
- H.-S. Chang, H.-J. Hsu, and K.-T. Chen. Modeling Exercise Relationships in E-Learning: A Unified Approach. In Educational Data Mining, pp. 532–535, 2015.